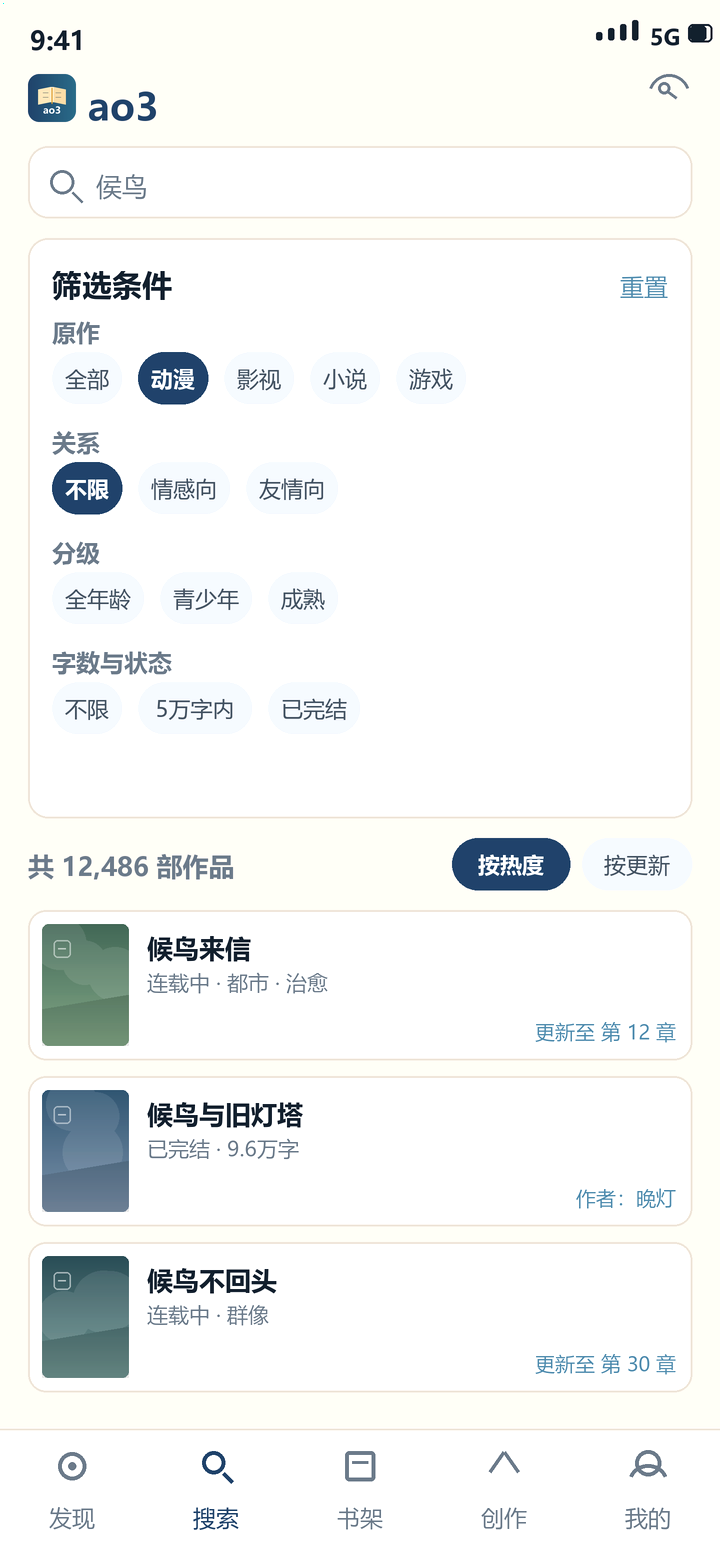
叠加筛选条件
原作、关系、分级、字数与状态可以同时勾选,结果数会跟着条件实时收敛,不用在翻页里反复试词。
关键词只能命中标题里出现过的字,标签却能把「谁和谁」「什么基调」「完结没有」这些条件叠加起来。三个动作支撑起这套检索:筛、存、接着读。
原作、关系、分级、字数与状态可以同时勾选,结果数会跟着条件实时收敛,不用在翻页里反复试词。
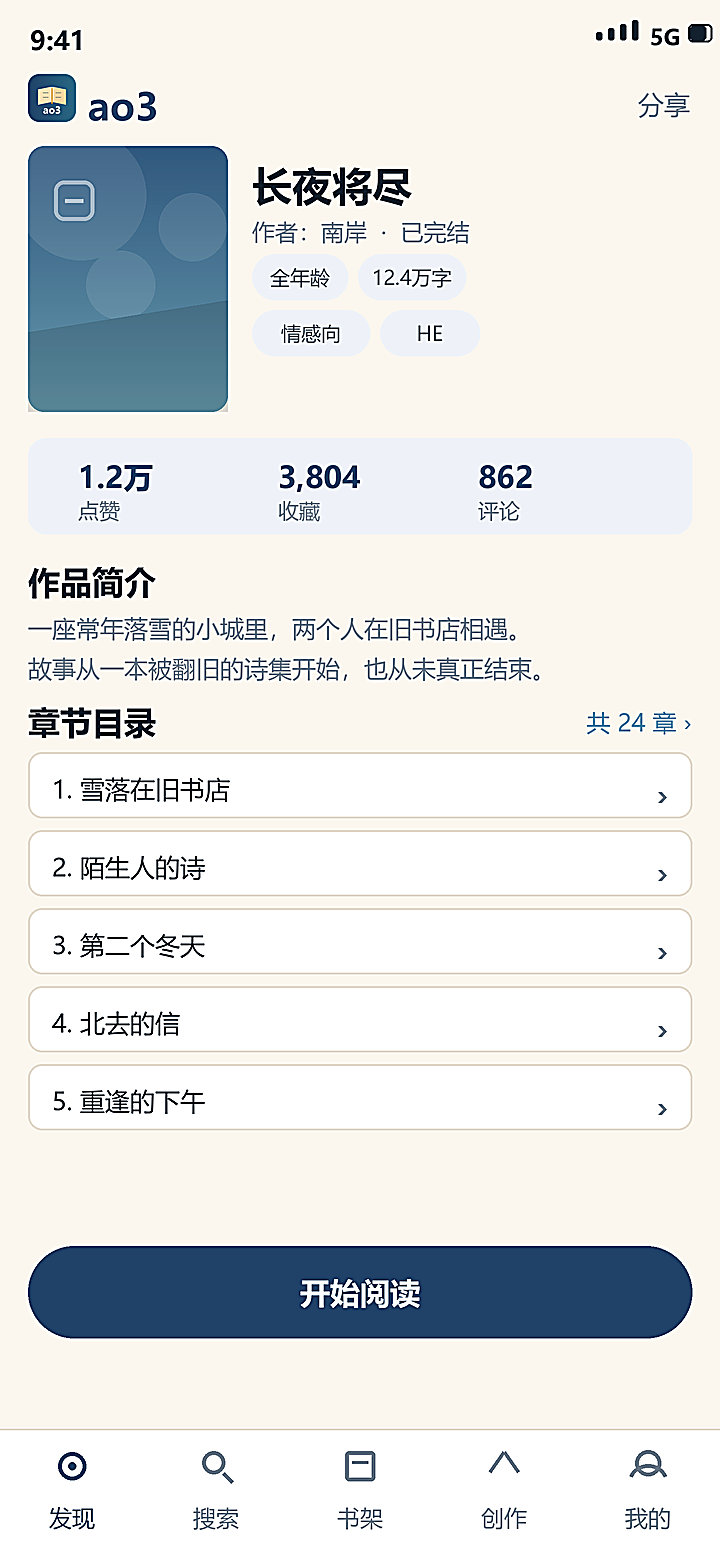
把作品收进书架后,读到哪一章由客户端记住;换设备登录同一个账号,进度与收藏会一起接过来。
整本或单章都能缓存,缓存文件只留在本机,卸载应用时一并清除,不占用账号侧的空间。
从找作品到把正文读进去,中间的每一步都留了可回退的位置,误触也不会把进度打乱。
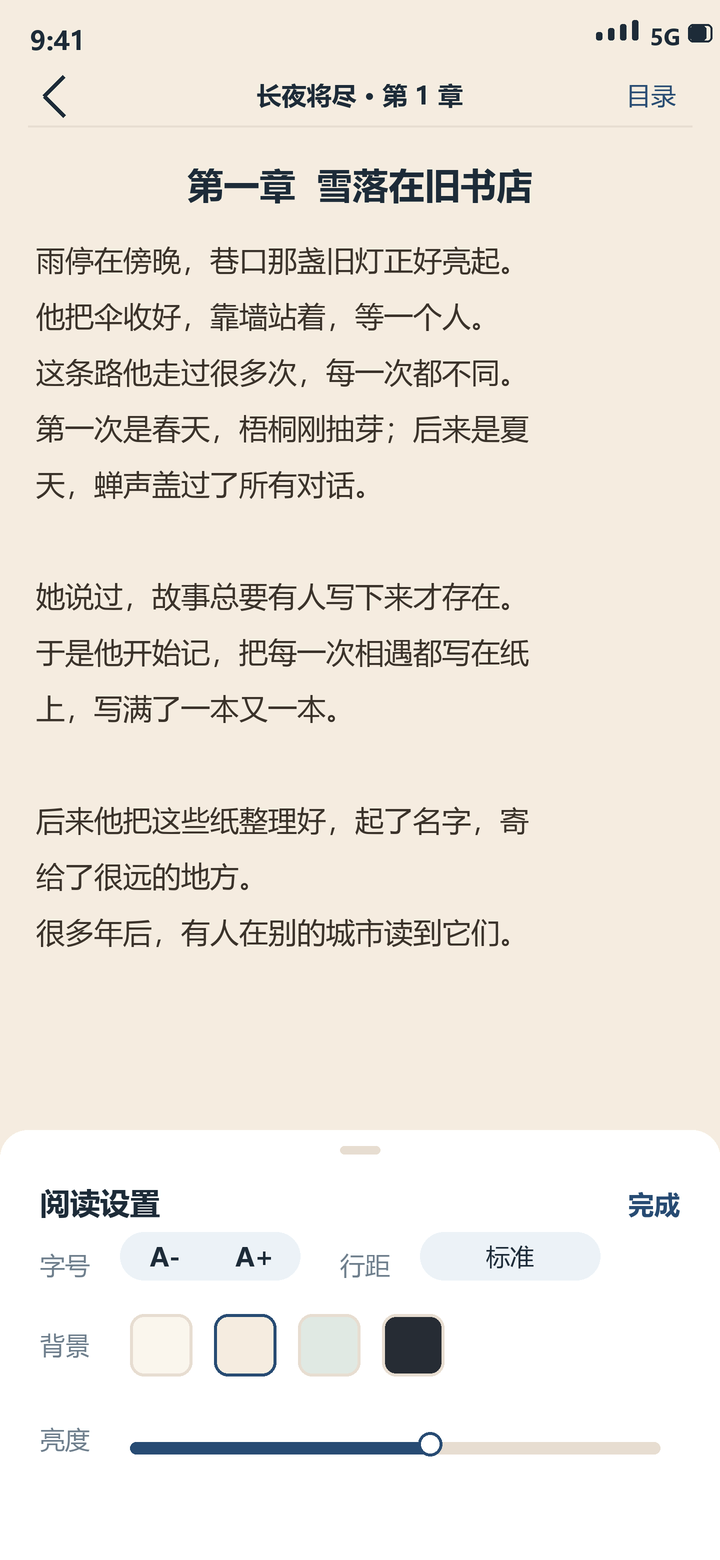
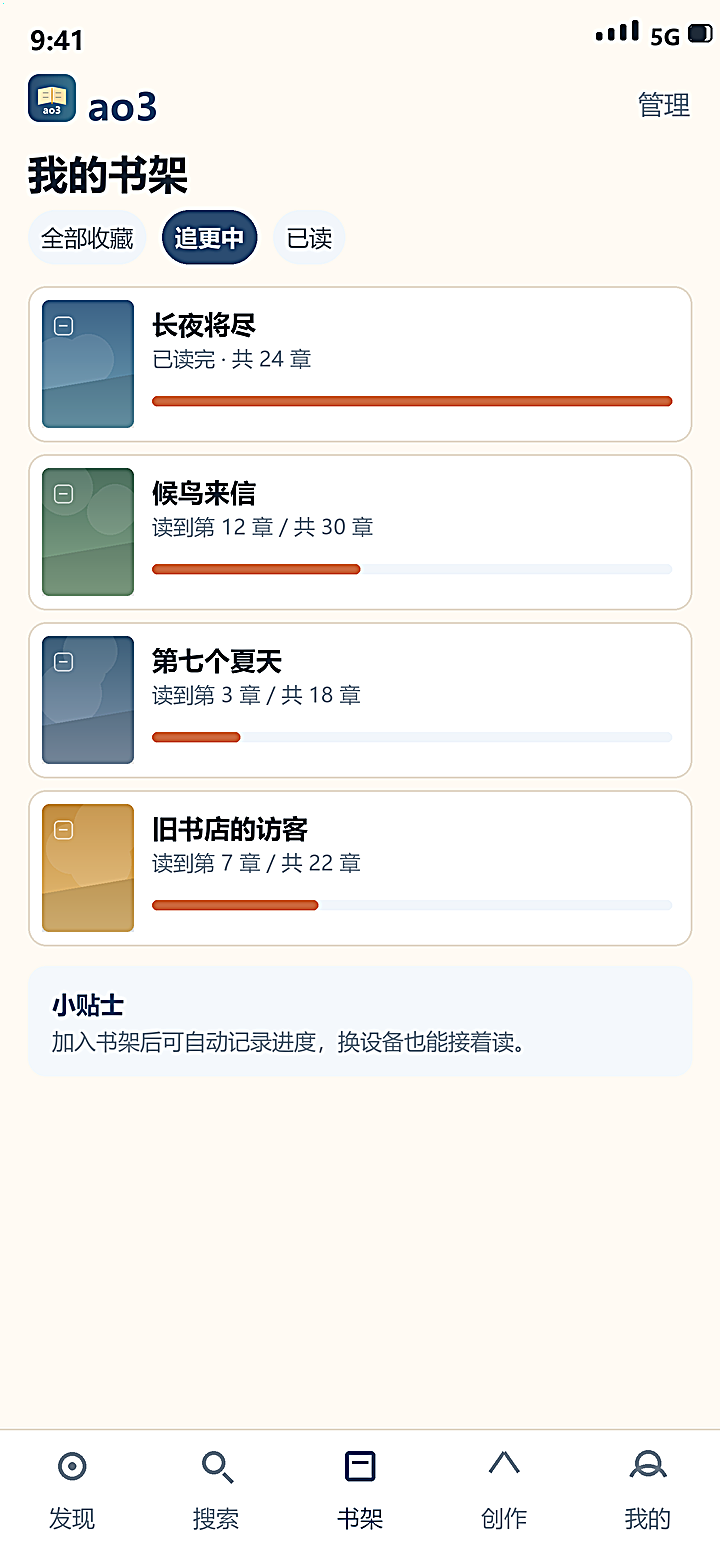
三种最常见的卡点分别落在不同环节,先确认自己卡在哪一种。
「最省事的是进度跟着账号走。白天在平板翻两章,晚上换手机打开还在同一段。」
— 追更党,用了一个完整连载周期
「标签叠加比关键词靠谱。以前要翻十几页才碰上一本合口味的,现在条件一勾就剩两三页。」
— 冷门配对读者
「地铁里信号断断续续,提前把整本存下来最稳妥,缓存区还能按占用空间清理。」
— 每天通勤四十分钟
不注册也能浏览和阅读大部分公开作品。注册的意义在于收藏、订阅更新与跨设备进度同步,缺了这些功能照样能用。
在「我的」里进入设置,找到语言一项切换到简体中文,重启应用后界面文字与菜单会整体跟随。
缓存只把已读或指定章节存到本机,缓存页会显示已用与可用空间,删掉作品即可随时回收。
登录同一个账号后,收藏与阅读进度会从账号侧取回;没有存到本地的章节需要重新缓存一次。